AI가 붙인 출처, 정말 그 말이 적혀 있습니까?
· 이치화 · 2분 읽기
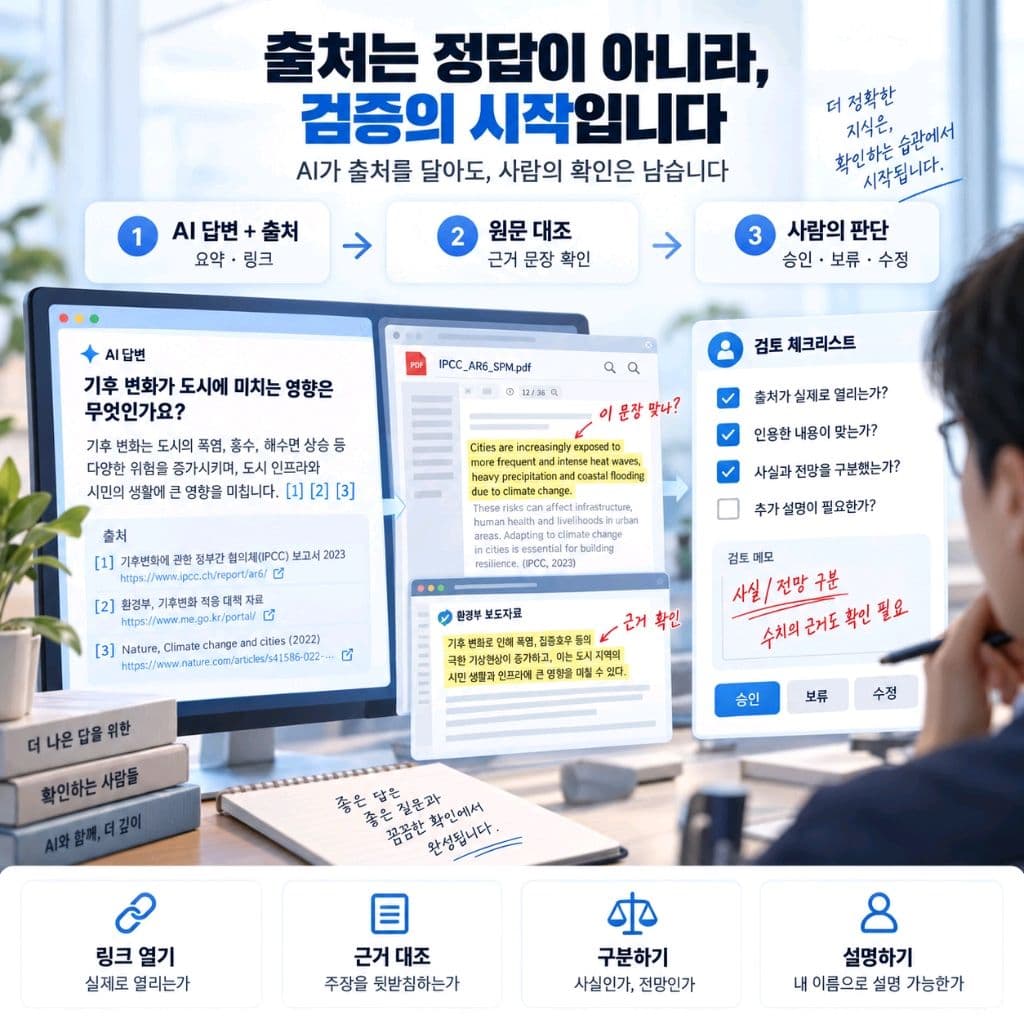
보고서를 쓰려고 AI에게 근거자료를 찾아달라고 합니다. 답변 아래에 논문과 보고서가 달려 있습니다. 링크를 누르니 실제 문서가 열립니다.
“출처까지 있으니 괜찮겠네.”
그런데 확인이 하나 남았습니다. 그 문서가 정말 AI의 설명을 뒷받침하는가.
가령 AI는 “업무시간이 줄었다”고 정리했는데, 원문에는 “업무시간이 줄어들 것으로 기대한다”고 적혀 있다면 어떨까요. 실제 성과와 기대는 다릅니다.
출처는 진짜여도, 설명은 틀릴 수 있습니다.
유명한 모델이라고 이 문제에서 자유로운 것도 아닙니다.
2026년 2월 공개된 ‘HalluHard’ 연구는 법률·의학·학술연구 등의 어려운 질문을 이어가며 AI의 답을 평가했습니다. 출처를 달라고 요구한 뒤, 그 출처가 실제로 존재하고 답변을 뒷받침하는지 확인했습니다.
학술연구 질문에서는 웹 검색을 허용했는데도, 추출·평가한 세부 주장 중 GPT-5.2 Thinking은 52.6%, Claude Opus 4.5는 29.6%가 환각으로 판정됐습니다.
출처가 틀리거나, 출처가 해당 주장을 뒷받침하지 못한 경우입니다. 어려운 전문 질문에 대한 자동 평가가 포함된 사전공개 연구로, 일상 대화의 오답률이라는 뜻은 아닙니다.
특히 연구진은 검색으로 출처 자체의 오류를 줄여도, 그 내용을 정확히 옮기는 문제는 남는다고 지적했습니다.
문제는 이용자는 출처가 붙으면 오히려 안심하기 쉽다는 데 있습니다. 2025년 AAAI 발표 연구에서는 인용이 붙은 AI 답변에 대한 신뢰가 높아졌습니다. 무작위로 붙인 인용에서도 효과가 나타났습니다.
확인할 수 있다는 느낌이, 확인했다는 사실을 대신할 수 있는 겁니다.
그래서 조직에서 “근거가 있습니까?” 다음에는 한 번 더 물어야 한다고 생각합니다.
“그 자료의 어느 문장이, 지금 이 결론을 뒷받침합니까?”
모든 링크를 같은 깊이로 읽기는 어렵습니다. 우선 의사결정을 바꾸는 숫자와 결론부터 대조해야 합니다. 조사 대상과 시점, 실제 결과인지 전망인지 확인하는 것입니다.
시스템도 출처 버튼을 붙이는 데서 끝내지 말고, 답변과 근거 문장을 나란히 보여줘야 합니다. 검증을 요구하려면 검증하기 쉽게 만들어야 합니다.
출처는 정답 도장이 아니라, 검증의 출발점입니다.
여러분은 출처가 있다는 것을 확인하십니까, 그리고 그 출처에 정말 그 말이 있는지 확인하시나요?
[출처]
Fan 외, "「HalluHard: A Hard Multi-Turn Hallucination Benchmark」" (https://arxiv.org/abs/2602.01031), 사전공개 논문 (2026.2.).
Ding 외, "「Citations and Trust in LLM Generated Responses」" (https://doi.org/10.1609/aaai.v39i22.34550), AAAI (2025).